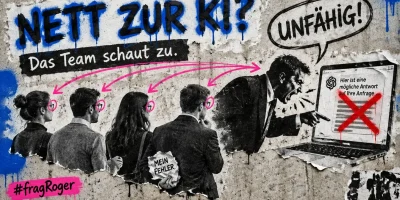
TLDR: Eine KI macht einen Fehler. Die Führungskraft reagiert genervt: „Was für ein Unsinn. Diese KI ist völlig unfähig.“ Das Team hört mit. Für die Maschine ist es eine weitere Eingabe. Für die Mitarbeitenden möglicherweise eine Botschaft darüber, wie ihre Führungskraft mit Fehlern umgeht. Ob sich diese Wirkung tatsächlich überträgt, ist wissenschaftlich noch nicht direkt bewiesen. Doch die Forschung zu Fehlerkultur, sozialem Lernen und dem Umgang mit Maschinen liefert bemerkenswerte Hinweise.
Ob jemand nett zur KI ist oder genervt auf ihre Fehler reagiert, ist selten eine private Angelegenheit. In Teams geschieht es vor Publikum. Und das Publikum liest daraus etwas ab, das mit der Maschine wenig zu tun hat: wie in diesem Umfeld auf Fehler reagiert wird.
Seit KI-Assistenten in Meetings, auf geteilten Bildschirmen und in gemeinsamen Dokumenten mitlaufen, ist der Umgang mit ihnen sichtbar geworden. Eine Führungskraft, die eine falsche Zusammenfassung mit „Völlig unbrauchbar“ kommentiert, korrigiert ein Werkzeug. Gleichzeitig sendet sie ein Signal. Mitarbeitende lernen die Regeln einer Organisation selten aus Leitbildern. Sie lernen sie aus beobachtetem Verhalten, vor allem aus dem Verhalten jener Personen, die über Beurteilungen, Projekte und Karrieren entscheiden.
Höflichkeit ist kein Prompt-Trick
Die Frage, ob man einer KI „Bitte“ und „Danke“ schreiben soll, wird meist technisch gestellt. Liefert das Modell bessere Antworten, wenn man freundlich ist? Die Antwort ist ernüchternd und gerade deshalb aufschlussreich.
Sprachmodelle reagieren auf Ton, weil Ton Teil des Textes ist, den sie verarbeiten. Ein grober Prompt kann andere Formulierungen auslösen als ein höflicher. Eine einfache Regel folgt daraus nicht. Welche Wirkung ein bestimmter Ton hat, hängt vom Modell, von der Aufgabe und von der Sprache ab.
Ein viel zitierter Test mit GPT-4o kam zu einem überraschenden Ergebnis: Sehr grobe Formulierungen erreichten bei Multiple-Choice-Fragen 84,8 Prozent korrekte Antworten, sehr höfliche 80,8 Prozent. Die Basis bildeten allerdings nur 50 Ausgangsfragen und ein einziges Modell. Eine Folgeuntersuchung derselben Autoren mit vier Modellen und zusätzlich 570 Wissensfragen fand Toneffekte, die stark von Modell und Aufgabe abhingen. Eine sprachübergreifende Studie auf Englisch, Chinesisch und Japanisch zeigte, dass unhöfliche Prompts die Leistung teilweise verschlechterten. Übertriebene Höflichkeit brachte allerdings ebenfalls keinen generellen Vorteil.
Wer nett zur KI ist, weil er bessere Antworten erwartet, baut auf schwachem Grund. Die tragfähigere Begründung liegt bei den Menschen, die zuschauen.
Was Menschen aus dem Umgang mit Maschinen mitnehmen
Die Interaktion mit einer Maschine ist für Menschen keine sozial neutrale Zone. Wer in einer Begegnung eine Haltung einnimmt, ob kooperativ, abwertend oder misstrauisch, trägt sie oft in die nächste Begegnung hinein. Psychologisch ist das kein Charakterwandel. Es ist eine kurzfristige Aktivierung von Einstellungen, die den folgenden Moment färbt.
In zwei Experimenten mit insgesamt 1’261 Teilnehmenden beurteilten Personen, die glaubten, mit einer KI gearbeitet zu haben, die Arbeit eines anderen Menschen anschliessend strenger. In zwei weiteren Experimenten mit 4’171 Erwachsenen aus den USA senkten unkooperative Bots die spätere Kooperationsbereitschaft gegenüber einer neuen Person, kooperative Bots erhöhten sie. Wer in Videoexperimenten beobachtete, wie ein Serviceroboter schlecht behandelt wurde, reagierte zweigeteilt: Bei einem Teil normalisierte die Szene unhöfliches Verhalten, bei einem anderen löste sie Empathie aus.
Das sind kurzfristige Effekte. Eine Langzeitstudie aus Deutschland, die 128 Familien über zweieinhalb Jahre begleitete, fand keine Verrohung. Die Höflichkeit von Kindern gegenüber Sprachassistenten blieb stabil, berichtete Aggression war gering. Der Umgang mit Maschinen formt Menschen also nicht automatisch um. Er beeinflusst jedoch die Situation, die unmittelbar darauf folgt. Führung findet in vielen solchen Situationen statt.
Fehlerkultur entsteht durch Beobachtung
Teams lernen ihre Fehlerkultur weniger aus Richtlinien als aus Erfahrungswerten. Mitarbeitende beobachten, was geschieht, wenn etwas schiefgeht. Wird nach Ursachen gefragt oder nach Schuldigen? Wird korrigiert oder abgewertet? Aus diesen Beobachtungen leiten sie ab, ob es sich lohnt, eigene Fehler offenzulegen.
Eine KI, die öffentlich beschimpft wird, trägt keine Konsequenzen. Die Reaktion zeigt trotzdem, wie die Führungskraft verarbeitet, wenn etwas nicht ihren Erwartungen entspricht. Für das Team ist das ein risikoloser Test: Man sieht die Reaktion, ohne selbst betroffen zu sein.
Wie stark solche Signale wirken, ist in der Organisationsforschung seit Jahrzehnten Thema. Eine Untersuchung in zwei US-Spitälern mit 146 Befragten zeigte bereits in den Neunzigerjahren, dass Stationen mit mehr registrierten Fehlern nicht zwingend die schlechteren waren. Die Zahlen massen auch, wie offen Fehler gemeldet wurden. In 65 niederländischen und 47 deutschen Organisationen hing aktives Fehlermanagement positiv mit wirtschaftlichen Leistungsindikatoren zusammen. In 54 belgischen Pflegeteams war vorgelebtes Sicherheitsverhalten der Leitung mit höherer psychologischer Sicherheit verbunden.
Auch Unhöflichkeit verbreitet sich. Erlebte und beobachtete Unhöflichkeit begünstigt nachfolgendes unhöfliches Verhalten, ähnlich einer Ansteckung. Eine Feldstudie mit 288 Arbeitsgruppen in den USA fand, dass abwertendes Führungsverhalten über Hierarchieebenen nach unten weitergegeben wird.
Keine dieser Studien untersucht direkt, ob ein Team eigene Fehler offener meldet, wenn die Führungskraft die KI sachlich korrigiert. Die Kette von der Maschine zum Menschen ist plausibel, aber nicht bewiesen. Sie setzt sich aus einzelnen, gut belegten Gliedern zusammen: Ton überträgt sich, Führung wird beobachtet, und Fehlerkultur entsteht aus dem, was beobachtet wird.
Freundlichkeit ist nicht Nachsicht
Respekt gegenüber KI kann in die falsche Richtung kippen. Wer Höflichkeit mit Nachsicht verwechselt, akzeptiert Antworten, die er prüfen müsste. Die Forschung zur sogenannten Sycophancy, dem Hang von Modellen, ihren Nutzenden nach dem Mund zu reden, zeigt die Kosten dieser Verwechslung.
Modelle, die gezielt auf Wärme trainiert wurden, machten in einer kontrollierten Studie mit fünf Modellfamilien um 7,43 Prozentpunkte häufiger Fehler. In drei Experimenten mit 2’405 Teilnehmenden verringerten bestätigende KI-Antworten die Bereitschaft, einen Konflikt zu reparieren, und stärkten die Selbstrechtfertigung. Aktuelle Benchmarks behandeln Wärme und konstruktiven Widerspruch deshalb als getrennte Eigenschaften. Ein Test vom Oktober 2026 fand, dass führende Modelle bei unbegründetem Widerspruch kaum noch nachgeben. Bei nur 30 geprüften Behauptungen bleibt die Aussagekraft allerdings begrenzt.
Diese Befunde betreffen das Verhalten der Modelle, nicht das „Bitte“ der Nutzenden. Sie zeigen aber, was ein guter Umgang mit Fehlern verlangt. Er ist weder grob noch weich. Er ist präzise.
Hinzu kommt eine Verzerrung auf der menschlichen Seite. Menschen verlieren nach algorithmischen Fehlern schneller Vertrauen als nach menschlichen, auch wenn der Algorithmus insgesamt besser abschneidet. Die genervte Reaktion auf eine KI spiegelt deshalb auch überhöhte Erwartungen an Maschinen. Führungskräfte, die das wissen, können ihre eigene Reaktion einordnen, bevor es das Team tut.
Was das für Führung bedeutet
Wie Führungskräfte mit KI umgehen, prägt, wie ihre Teams sie nutzen. Umfragedaten zeigen bei starker Unterstützung durch Vorgesetzte eine 2,1-mal höhere Wahrscheinlichkeit regelmässiger KI-Nutzung. Ein Unternehmensbericht kommt auf einen ähnlichen Faktor. Eine Studie mit 381 Beschäftigten in südkoreanischen Unternehmen fand, dass ethische Führung den negativen Zusammenhang zwischen KI-Einführung und psychologischer Sicherheit abschwächte. Und in China hing aktives Gestalten der eigenen Arbeit mit KI durch Führungskräfte mit höherer Selbstwirksamkeit und mehr Innovationsverhalten der Mitarbeitenden zusammen.
Damit wird der Umgang mit KI zu einem Teil des Führungsverhaltens. Er ist sichtbar, wiederholt sich täglich und betrifft genau das Feld, in dem Organisationen gerade lernen müssen. Wer einer KI Fehler sachlich zurückmeldet, nach der Ursache fragt, die Anweisung präzisiert und das Ergebnis prüft, zeigt dem Team ein Verfahren. Wer abwertet, zeigt ein anderes.
Ein einfacher Prüfstein hilft: Würde ich gleich reagieren, wenn dieselbe falsche Zusammenfassung von einer neuen Mitarbeiterin käme? Lautet die Antwort nein, stellt sich die Frage, welche der beiden Reaktionen das Team für die gültige hält.
Höflichkeit gegenüber Maschinen ist kein Gefallen an die Technik. Sie ist ein Standard, den das Team mitliest. Die KI vergisst den Ton beim nächsten Prompt. Das Team behält ihn.
Quellen
Artificial Analysis. (2026, October 19). Announcing AA-PersonalityBench: Measuring how AI models communicate. https://artificialanalysis.ai/de/articles/aa-personalitybench
Artificial Analysis. (n.d.). AA-PersonalityBench methodology. https://artificialanalysis.ai/methodology/aa-personalitybench
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. https://doi.org/10.1126/science.aec8352
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126. https://doi.org/10.1037/xge0000033
Dobariya, O., & Kumar, A. (2025). Mind your tone: Investigating how prompt politeness affects LLM accuracy (short paper) [Preprint]. arXiv. https://arxiv.org/abs/2510.04950
Dobariya, O., & Kumar, A. (2026). Mind your tone: Does tone alter LLM performance? [Preprint]. arXiv. https://arxiv.org/abs/2605.29027
Edmondson, A. C. (1996). Learning from mistakes is easier said than done: Group and organizational influences on the detection and correction of human error. The Journal of Applied Behavioral Science, 32(1), 5–28. https://doi.org/10.1177/0021886396321001
Foulk, T., Woolum, A., & Erez, A. (2016). Catching rudeness is like catching a cold: The contagion effects of low-intensity negative behaviors. Journal of Applied Psychology, 101(1), 50–67. https://doi.org/10.1037/apl0000037
Gong, T., & Huang, Y.-S. (2026). Witnessing robot mistreatment: A dual-path model of behavioral contagion and empathy in customer observers. Journal of Retailing and Consumer Services, 88, Article 104482. https://doi.org/10.1016/j.jretconser.2025.104482
Harrell, A., & Traeger, M. L. (2025). Evidence of spillovers from (non)cooperative human-bot to human-human interactions. iScience, 28(8), 113006. https://doi.org/10.1016/j.isci.2025.113006
Ibrahim, L., Hafner, F. S., & Rocher, L. (2026). Training language models to be warm can reduce accuracy and increase sycophancy. Nature, 652, 1159–1165. https://doi.org/10.1038/s41586-026-10410-0
Kemp, A. (2025, November 8). Manager support drives employee AI adoption. Gallup. https://www.gallup.com/workplace/694682/manager-support-drives-employee-adoption.aspx
Kim, B.-J., Kim, M.-J., & Lee, J. (2025). The dark side of artificial intelligence adoption: Linking artificial intelligence adoption to employee depression via psychological safety and ethical leadership. Humanities and Social Sciences Communications, 12, Article 704. https://doi.org/10.1057/s41599-025-05040-2
Leroy, H., Dierynck, B., Anseel, F., Simons, T., Halbesleben, J. R. B., McCaughey, D., Savage, G. T., & Sels, L. (2012). Behavioral integrity for safety, priority of safety, psychological safety, and patient safety: A team-level study. Journal of Applied Psychology, 97(6), 1273–1281. https://doi.org/10.1037/a0030076
Mawritz, M. B., Mayer, D. M., Hoobler, J. M., Wayne, S. J., & Marinova, S. V. (2012). A trickle-down model of abusive supervision. Personnel Psychology, 65(2), 325–357. https://doi.org/10.1111/j.1744-6570.2012.01246.x
Pu, T., Lei, R., Siyal, A. W., & Li, Y. (2026). From AI adaptation to innovation: How leader AI crafting shapes employee innovative behavior. Frontiers in Psychology, 17, Article 1847344. https://doi.org/10.3389/fpsyg.2026.1847344
Strathmann, C., Horstmann, A. C., Szczuka, J. M., & Krämer, N. C. (2026). Alexa, shut up! A 2.5-year study on negatively connotated communication behaviour towards voice assistants in the family home. Behaviour & Information Technology, 45(5), 821–839. https://doi.org/10.1080/0144929X.2025.2533352
Tey, K. S., Mazar, A., Tomaino, G., Duckworth, A. L., & Ungar, L. H. (2024). People judge others more harshly after talking to bots. PNAS Nexus, 3(9), pgae397. https://doi.org/10.1093/pnasnexus/pgae397
TrueStandard. (2026, October 22). AI sycophancy benchmark: Which models fold. https://truestandard.ai/ai-sycophancy-benchmark
van Dyck, C., Frese, M., Baer, M., & Sonnentag, S. (2005). Organizational error management culture and its impact on performance: A two-study replication. Journal of Applied Psychology, 90(6), 1228–1240. https://doi.org/10.1037/0021-9010.90.6.1228
Wolkin, A. (2026, February 25). Upskilling in the AI era: FY25 purpose report. Cisco Blogs. https://blogs.cisco.com/our-corporate-purpose/upskilling-in-the-ai-era-fy25-purpose-report
Yin, Z., Wang, H., Horio, K., Kawahara, D., & Sekine, S. (2024). Should we respect LLMs? A cross-lingual study on the influence of prompt politeness on LLM performance. In J. Hale, K. Chawla, & M. Garg (Eds.), Proceedings of the Second Workshop on Social Influence in Conversations (SICon 2024) (pp. 9–35). Association for Computational Linguistics. https://doi.org/10.18653/v1/2024.sicon-1.2